
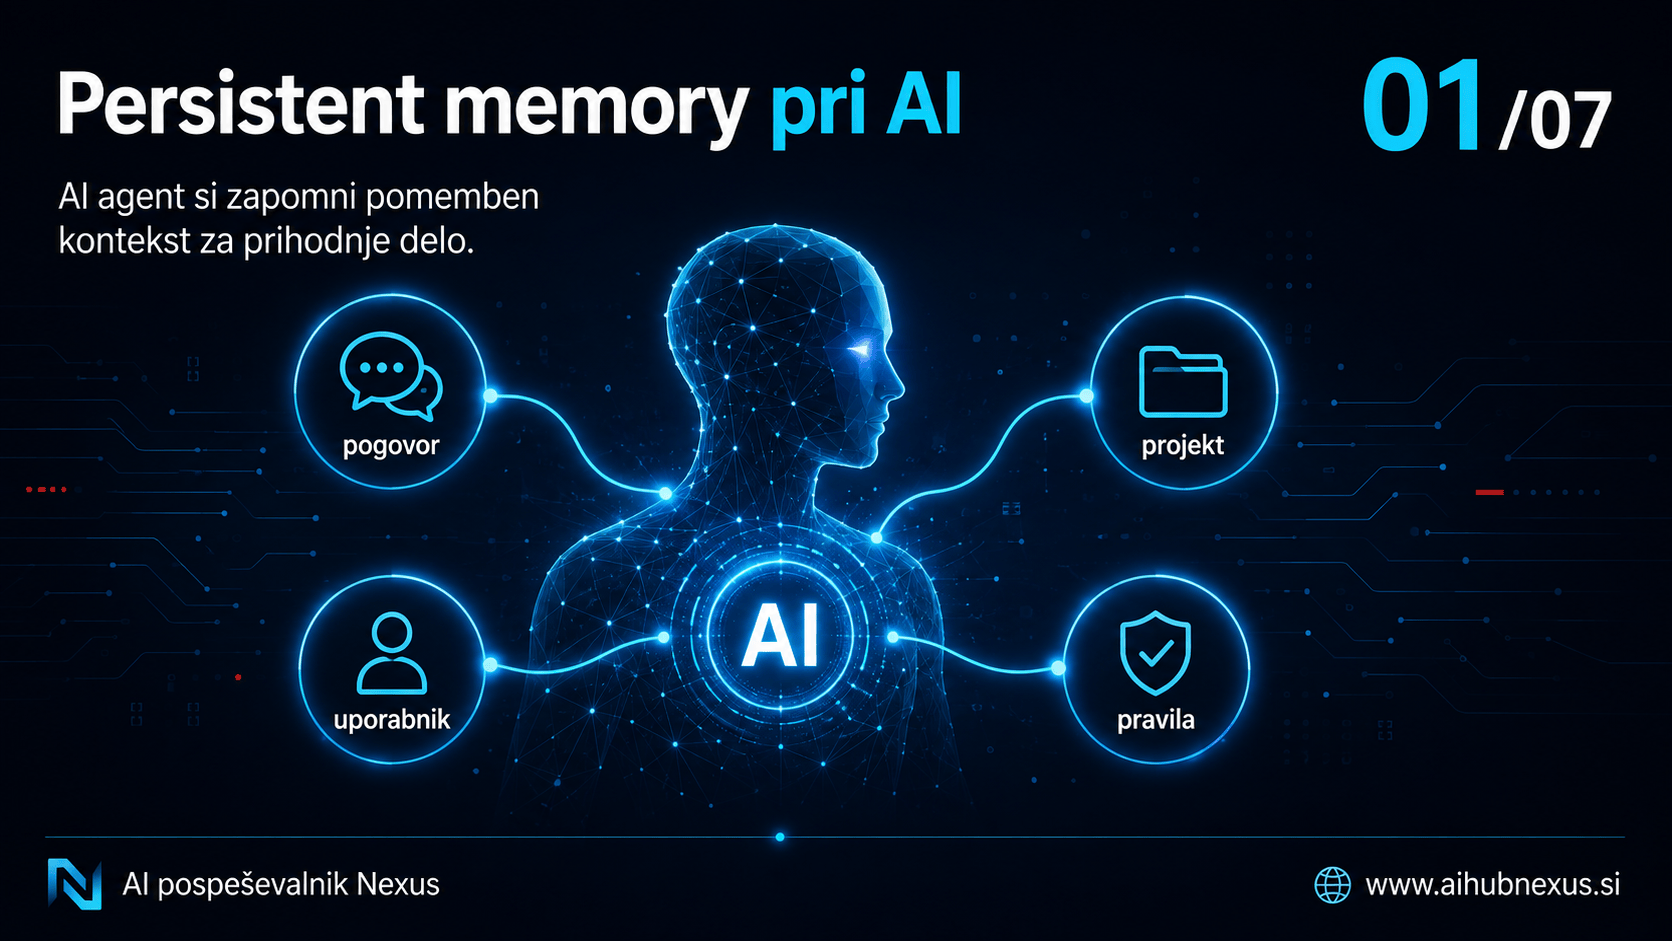
Persistent memory je ena izmed funkcij, ki AI počasi premika iz enkratnega klepetalnika v dolgoročnega digitalnega sodelavca. Ne gre za to, da bi si umetna inteligenca morala zapomniti vse. Prava vrednost je v tem, da zna ohraniti prave informacije: stabilen kontekst, preference, postopke in varnostna pravila.
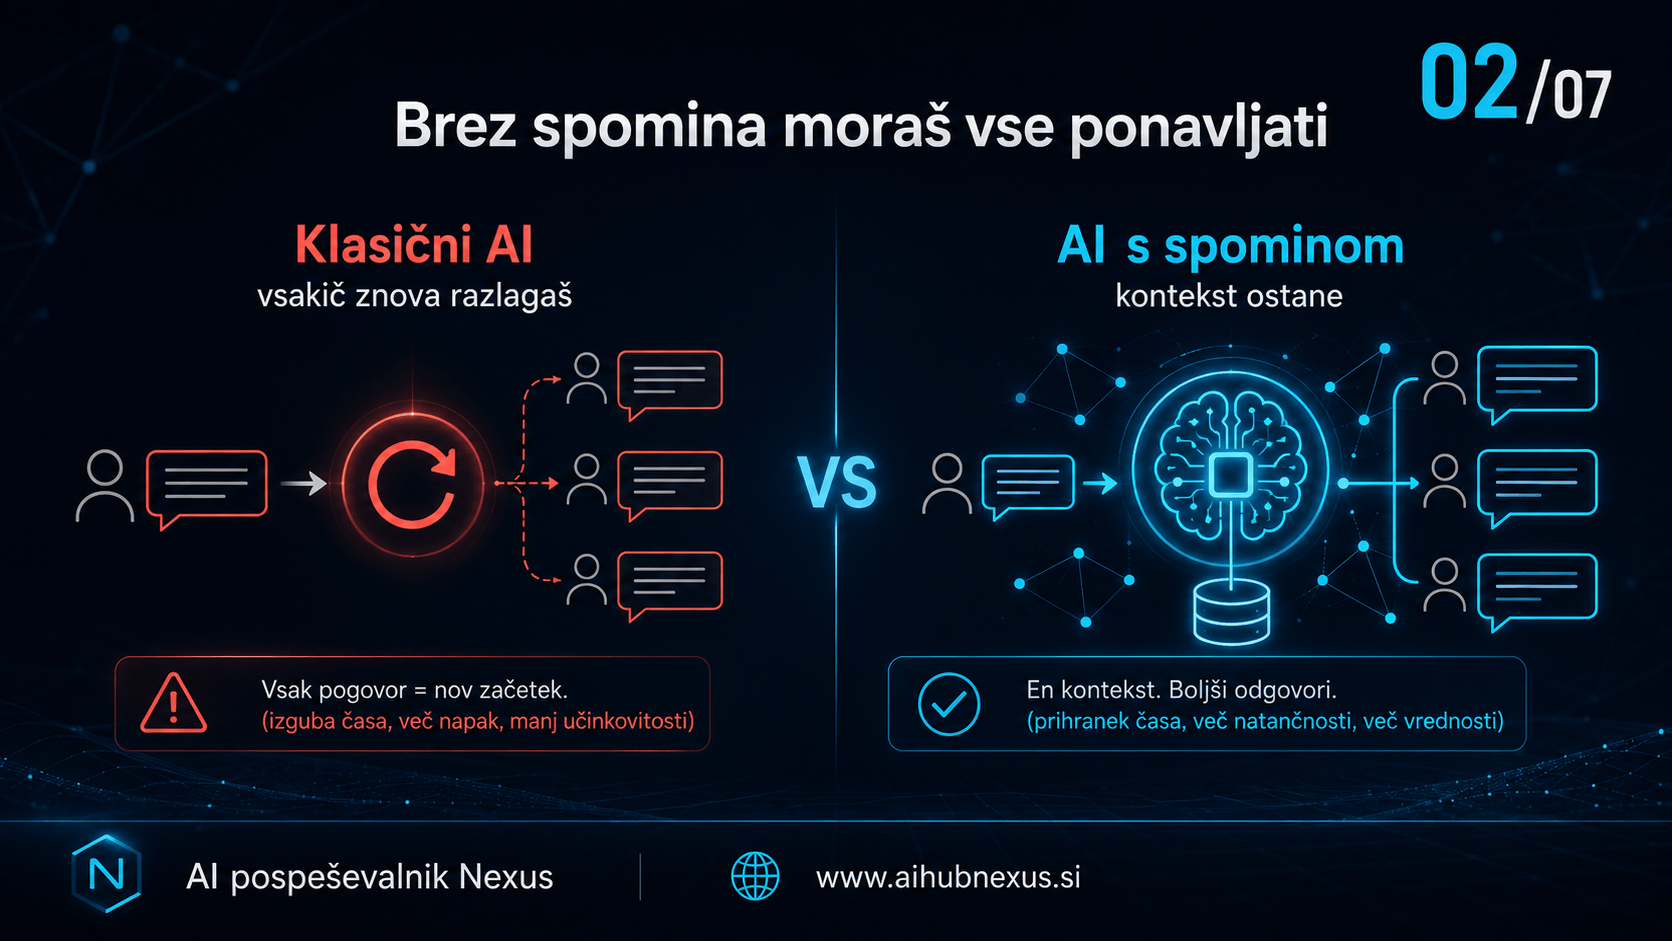
Pri AI agentih je to še pomembnejše kot pri navadnem klepetu. Agent ne samo odgovarja, ampak uporablja orodja, išče podatke, piše dokumente, kliče API-je, izvaja avtomatizacije in preverja rezultate. Če nima spomina, mu moramo vsakokrat razlagati isto ozadje. Če ima dobro urejen spomin, pa lahko dela hitreje, bolj osebno in bolj varno.
Kaj sploh je persistent memory?
Persistent memory oziroma trajni spomin pomeni, da AI sistem določene informacije shrani izven trenutnega pogovora in jih lahko uporabi kasneje. To ni isto kot kontekstno okno. Kontekstno okno je začasen del pogovora, ki ga model vidi med trenutno sejo. Trajni spomin pa je namenjen informacijam, ki so uporabne tudi čez dan, teden ali mesec.
OpenAI na primer pri ChatGPT memory opisuje možnost, da si sistem zapomni informacije, ki jih uporabnik izrecno pove ali jih sistem sklepa iz pogovorov, uporabnik pa lahko spomine pregleduje, briše ali izklopi.[1] Pri agentnih frameworkih, kot je LangChain, se pogosto ločuje med kratkoročnim spominom znotraj pogovorne niti in dolgoročnim spominom, ki je shranjen po uporabnikih, projektih ali aplikacijah.[2][3]
Kako deluje pri AI agentih?
AI agent običajno deluje v zanki: razume cilj, pripravi naslednji korak, uporabi orodje, pogleda rezultat, popravi smer in nadaljuje. Persistent memory mu pomaga pri tem, da ne začne vsakič iz nič. V praksi je spomin pogosto razdeljen na več plasti.
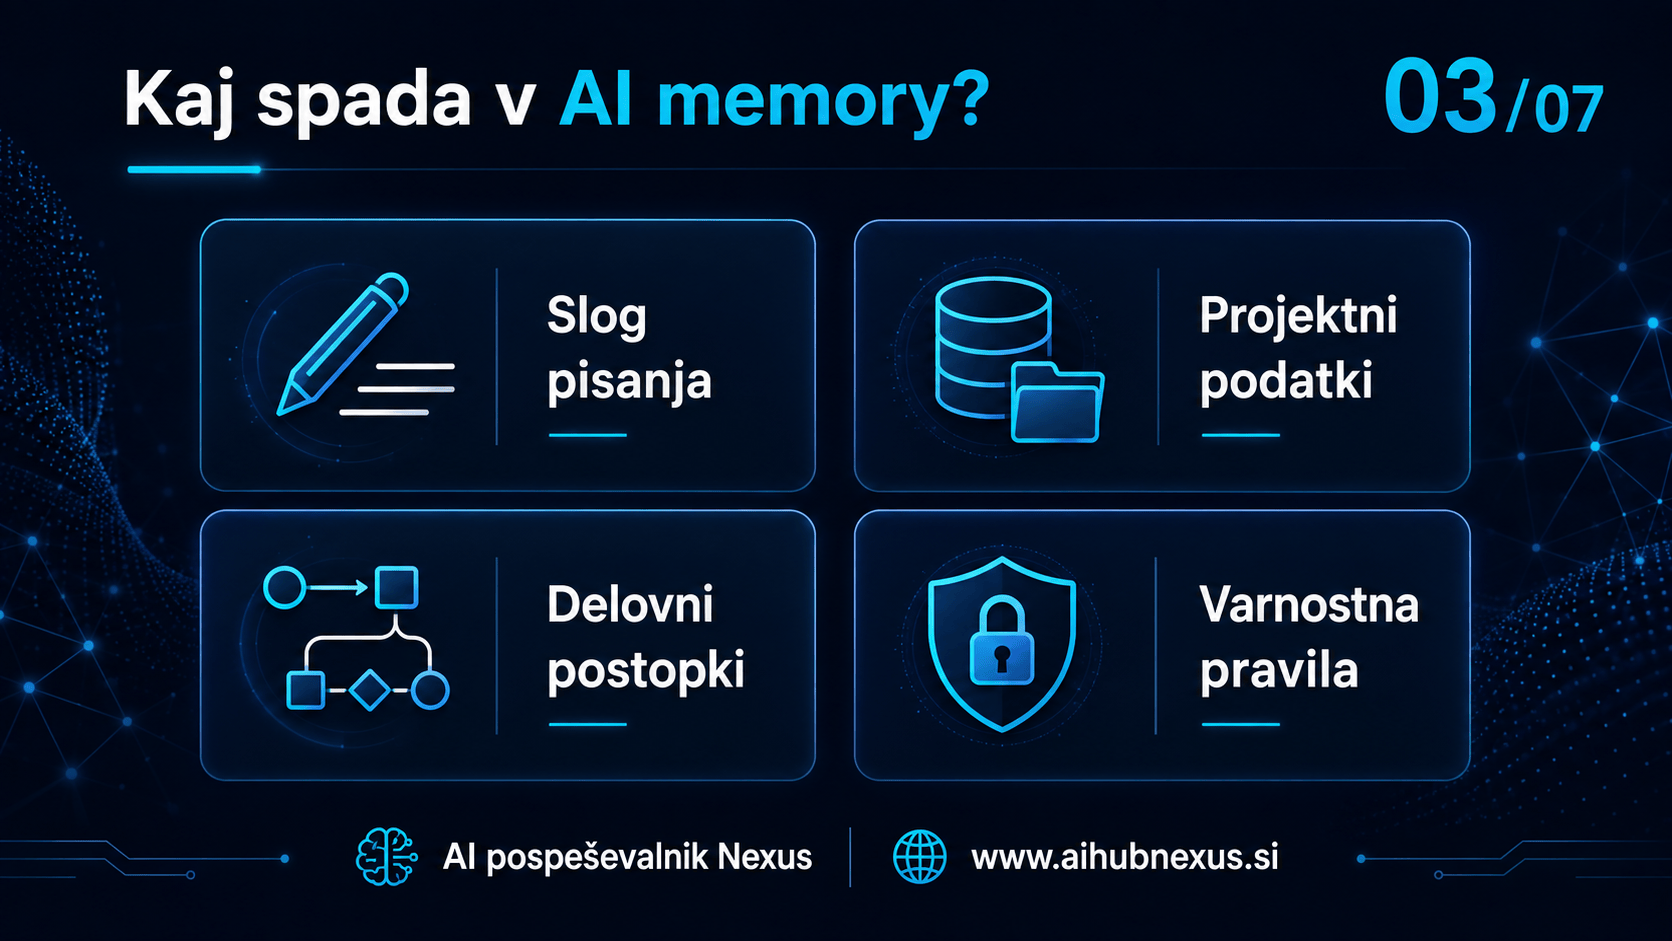
Štiri plasti uporabnega AI spomina
- Uporabniški profil: jezik, ton, način razlage, preference glede dolžine in oblike odgovorov.
- Projektni spomin: stalne informacije o spletni strani, mapah, znamki, občinstvu, postopkih in omejitvah.
- Proceduralni spomin: preverjeni delovni postopki — na primer kako pripraviti članek, objaviti blog ali preveriti rezultat.
- Priklic iz virov: iskanje po dokumentih, preteklih sejah, bazah znanja ali zunanjih sistemih.
LangChain pri dolgoročnem spominu opisuje tipične vzorce, kjer se informacije shranjujejo in prikličejo glede na uporabnika, pogovor ali aplikacijski kontekst.[3] V novejših AI produktih se ta ideja premika tudi v uporabniško izkušnjo: Anthropic na primer pri Claude memory poudarja projektni in uporabniški kontekst, ki ga je mogoče urejati in izklopiti.[4]
Zakaj je persistent memory pomemben?
Največja korist ni v tem, da AI »ve več«, ampak da zmanjša trenje. Če vsak dan pripravljamo vsebine, analiziramo poročila ali vodimo avtomatizacije, je ponavljanje osnovnih navodil izguba časa. Agent, ki pozna stabilen kontekst, lahko hitreje pride do uporabnega rezultata.
Graf: odločitev, kaj gre v spomin
Najboljši AI spomin je selektiven. Če v spomin shranimo vse, dobimo šum, tveganje za zasebnost in zastarele informacije. Če shranimo samo stabilne vzorce, dobimo večjo uporabnost brez nepotrebnega kopičenja podatkov.
Je stabilno?
Če bo veljalo čez mesec dni, je kandidat za spomin.
Zmanjša ponavljanje?
Če uporabniku prihrani razlago, je koristno.
Je občutljivo?
Gesla, ključi in osebni podatki ne sodijo v trajni spomin.
Je preverljivo?
Spomin mora biti kratek, popravljiv in razumljiv.
Kje ga lahko uporabljamo?
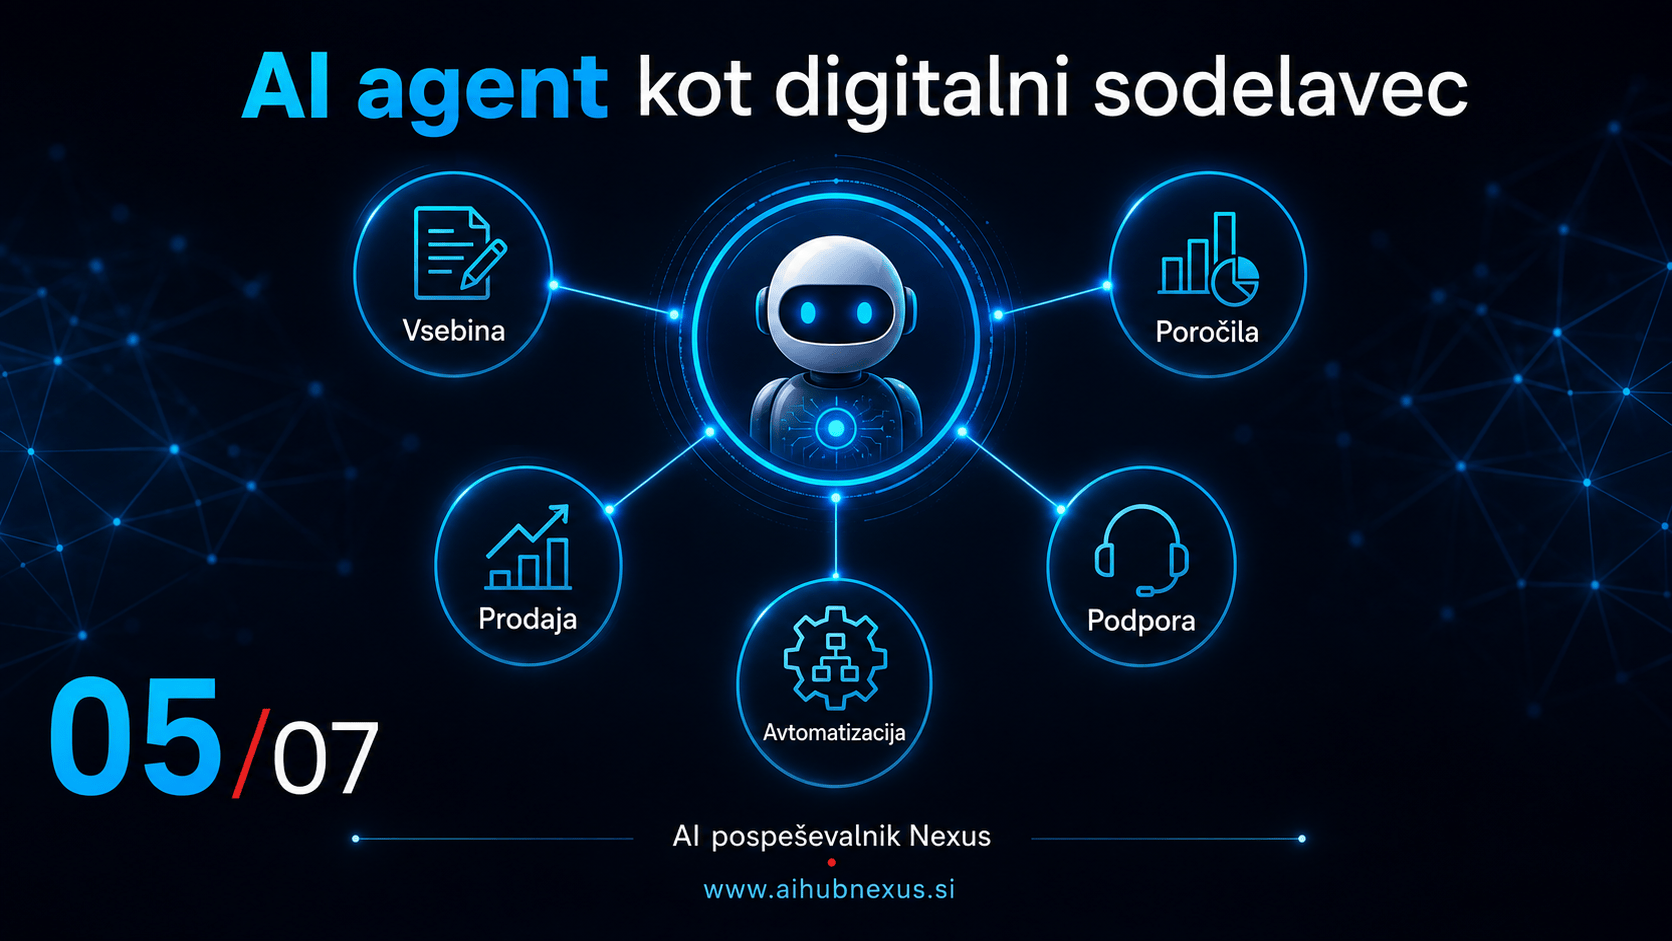
Pri osebnem delu si agent lahko zapomni, da imamo radi kratke povzetke, slovenski jezik, določeno strukturo dokumentov ali poseben slog komunikacije. Pri podjetjih je vrednost še večja: agent lahko pozna interne postopke, blagovno znamko, ciljne skupine, ton komunikacije, pogosto uporabljene vire in varnostne omejitve.
V praksi se persistent memory dobro ujema z orodji, kot je Model Context Protocol, ki standardizira povezovanje AI aplikacij z zunanjimi sistemi in viri podatkov.[5] Spomin namreč ni uporaben samo kot zapis v profilu, ampak kot del širšega agentnega sistema: uporabniški kontekst, projektni dokumenti, baze znanja, orodja in preverjanje rezultatov.
Največja nevarnost: napačen ali preširok spomin
Persistent memory odpira resna vprašanja zasebnosti. Če AI začne shranjevati preveč informacij, lahko postane tveganje. Če si zapomni napačno informacijo, jo lahko ponavlja. Če hrani občutljive podatke, se poveča možnost zlorabe ali nenamernega razkritja.
Zato je koristno upoštevati načelo minimizacije podatkov: osebni podatki morajo biti ustrezni, relevantni in omejeni na to, kar je potrebno za namen obdelave.[6] Pri AI agentih to prevedemo zelo praktično: v spomin naj gre samo tisto, kar agent zares potrebuje za boljše in varnejše delo.
Kako začeti v podjetju ali pri osebnem delu?
Začnite z majhnim in nadzorovanim spominom. Najprej določite, katere informacije so res stabilne in koristne: slog komunikacije, pogoste vrste nalog, projektna pravila, varnostne omejitve in preverjeni postopki. Nato dodajte pravilo, da se občutljive informacije ne shranjujejo.
Pomembno je tudi, da ima uporabnik možnost pregleda in popravka. Spomin ne sme biti skrivna črna škatla. Najboljši sistemi uporabniku pokažejo, kaj si je AI zapomnil, in omogočijo brisanje ali izklop. To je pomembno tako za zaupanje kot za kakovost dela.
Zaključek: AI ne potrebuje popolnega spomina, ampak dober spomin
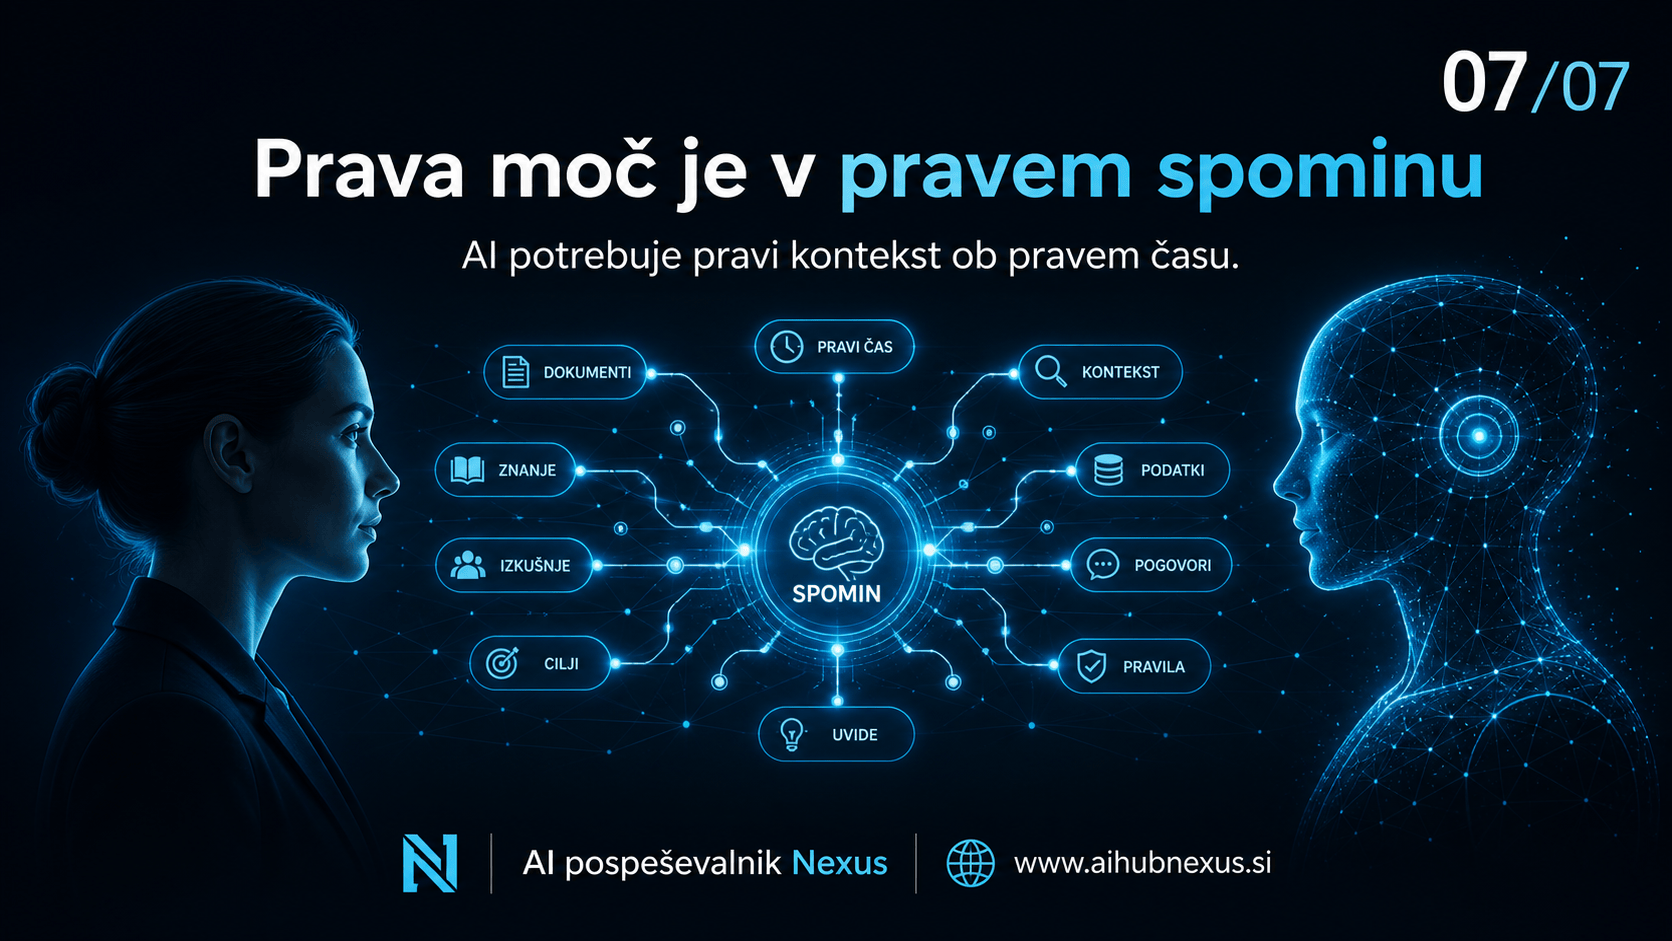
Persistent memory je eden ključnih gradnikov prihodnjih AI agentov. Brez njega agent ostane pameten, a pozabljiv pomočnik. Z njim lahko postane bolj dosleden, bolj oseben in bolj uporaben sodelavec.
Toda cilj ni, da si AI zapomni vse. Cilj je, da si zapomni prave stvari: stabilne preference, projektni kontekst, delovne postopke in varnostna pravila. Dober AI spomin mora biti kratek, uporaben, popravljiv in varen. Ravno v tej selektivnosti je njegova prava moč.